

Ещё пять лет назад типичный стек AI-стартапа выглядел предельно просто: фронтенд на React, бэкенд на Python, а «мозги» — один вызов OpenAI API. Быстро, дёшево, качественно.
Сегодня для любого проекта, работающего с персональными данными российских пользователей, такой подход уже не проходит. Нужно понимать, какие данные обрабатываются, где они физически находятся, какие компоненты AI-системы к ним получают доступ и какие внешние сервисы вообще участвуют в обработке. И самая распространённая ошибка — воспринимать всю задачу как простой выбор между «российской LLM» и «зарубежной LLM». На деле это не вопрос выбора вендора. Это архитектурная задача, причём далеко не тривиальная.
В статье разбираем: что действительно нужно учитывать при проектировании AI-системы; почему локализация базы данных и локализация LLM — это два разных вопроса; какие есть рабочие варианты — YandexGPT, GigaChat, self-hosted Qwen/DeepSeek и гибридные схемы; почему RAG, embeddings и vector DB тоже становятся частью контура данных, а не остаются «просто инфраструктурой»; зачем нужен собственный AI Gateway; как строить обезличивание так, чтобы это не сводилось к паре regex-выражений; сколько инженерных ресурсов реально требует self-hosted inference; как считать экономику API против собственных GPU; и как в итоге построить архитектуру, которую не придётся переписывать при смене модели или требований к комплаенсу.
Что на самом деле требует 152-ФЗ
Начнём с занудной, но необходимой части.
Многие путают требование «хранить данные в РФ» с требованием «использовать только российский ИИ». Это не одно и то же, и для архитектуры продукта разница здесь принципиальна. Статья 18 152-ФЗ устанавливает требования к локализации персональных данных именно при их первичном сборе — а значит, техническое решение нельзя сводить к вопросу «какой LLM-провайдер находится в России».
Главный вопрос, который на самом деле должен задавать себе архитектор, звучит иначе:
Какие данные проходят через каждый компонент системы и где происходит их обработка?
На практике систему полезно разделить минимум на несколько зон:
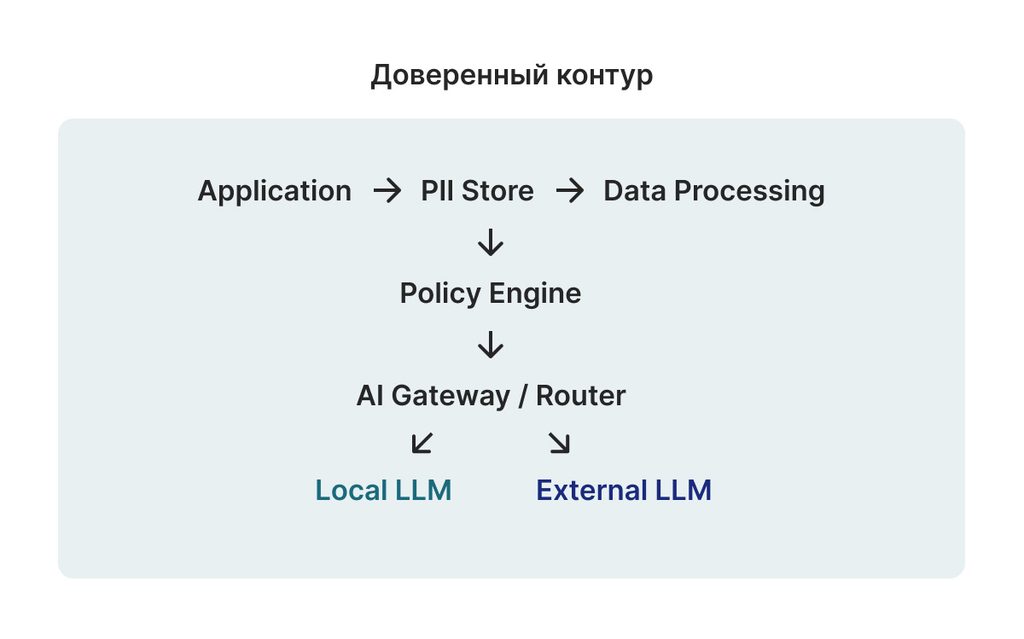
И вот эта схема важнее, чем само название модели, которую вы в итоге выберете.
Какие данные являются критичными
Если продукт работает с ПДн, недостаточно учесть только очевидные поля — ФИО, телефон, email, паспортные данные, адрес, геолокацию. Персональные данные прекрасно прячутся и внутри свободного текста:
«Здравствуйте, я Иван Петров, мой заказ №12345 не приехал по адресу…»
А в AI-системах есть ещё целый набор куда менее очевидных мест утечки: prompt, chat history, RAG context, vector database, embeddings, application logs, traces, error reports, аналитика, telemetry, кэш, backups, dataset для последующего fine-tuning. Проверить одну основную PostgreSQL-базу и успокоиться — этого попросту недостаточно.
RAG меняет архитектуру
Для современного AI-продукта типичная схема выглядит примерно так:
User
  ↓
Application
  ↓
Retriever
  ↓
Vector DB
  ↓
Documents / chunks
  ↓
Prompt construction
  ↓
LLM
Допустим, разработчик уверенно говорит: «Мы не отправляем персональные данные в зарубежную LLM». А тем временем retriever автоматически подставляет в prompt фрагмент документа:
Иван Иванов
Дата рождения: ...
Номер договора: ...
История обращений: ...
И вот персональные данные всё-таки попадают в LLM — просто через чёрный ход, о котором никто не подумал. Поэтому vector DB, document storage и retrieval pipeline нужно рассматривать как часть data-flow, а не как второстепенную инфраструктуру, которую можно проверить в последнюю очередь.
Практическое следствие
Для каждого AI-компонента полезно составить таблицу такого вида:
| Компонент | Какие данные получает | Где работает | Может содержать ПДн |
|---|---|---|---|
| PostgreSQL | Профили пользователей | РФ | Да |
| Object Storage | Документы | РФ | Да |
| Vector DB | Embeddings + metadata | РФ | Потенциально |
| NER/PII service | Тексты | РФ | Да |
| AI Gateway | Prompts/context | РФ | Потенциально |
| Local LLM | Prompt | РФ | Потенциально |
| External LLM | Обезличенный prompt | Вне РФ | Только после проверки политики |
Такой inventory на практике полезнее любой декларации в духе «мы используем российское облако» — потому что показывает конкретные точки риска, а не общее заверение.
Три пути, которые выбирают команды
На практике сложились три основных подхода: российские коммерческие LLM по API, self-hosted открытые модели и гибридная архитектура. Но за этим делением стоит более фундаментальный вопрос — где находятся данные и где выполняется reasoning. Эти два слоя вовсе не обязаны жить в одном месте, и именно это разделение открывает пространство для манёвра.
Путь 1. Российские коммерческие LLM по API
Самый быстрый способ начать разработку — использовать коммерческий российский API, например YandexGPT или GigaChat. Плюсы очевидны: готовый API, биллинг, квоты, мониторинг, SDK, документация, отсутствие необходимости самому эксплуатировать GPU, относительно простой путь от MVP к production.
Если приложение уже построено вокруг API abstraction layer, подключение нового провайдера может выглядеть примерно так:
class LLMProvider:
    def generate(self, messages, **kwargs):
        raise NotImplementedError


class RussianCloudProvider(LLMProvider):
    def generate(self, messages, **kwargs):
        ...


class OpenSourceProvider(LLMProvider):
    def generate(self, messages, **kwargs):
        ...
Это небольшое архитектурное решение, принятое на старте, впоследствии способно сэкономить месяцы миграции.
YandexGPT
YandexGPT доступен через инфраструктуру Yandex Cloud Foundation Models. Из плюсов — готовая облачная инфраструктура, интеграция с другими сервисами облака, управление квотами и доступом, возможность работать без собственной GPU-фермы, а также определённая гибкость адаптации модели в рамках того, что предоставляет вендор. Особенно логичен такой выбор для команд, которые уже сидят в российском облаке и хотят по максимуму упростить инфраструктуру.
GigaChat
GigaChat решает ту же задачу — даёт готовую LLM-инфраструктуру через API. При выборе между провайдерами не стоит ориентироваться на субъективное впечатление от нескольких тестовых ответов модели — этого категорически недостаточно. Нужно тестировать собственный workload: accuracy, latency, cost, structured output, function calling, long context, качество русского языка, hallucination rate, JSON validity, availability, rate limits. Именно эти цифры, а не общее ощущение «модель мне понравилась», должны стать основанием выбора для production.
Главный недостаток коммерческого API
Вы контролируете приложение, но не контролируете модельный runtime. Вендор в любой момент может изменить модель, latency, лимиты, цены, поведение API, системные ограничения — и вы узнаете об этом постфактум. Поэтому даже при использовании коммерческого API желательно иметь прослойку:
Application
      ↓
LLM Gateway
      ↓
Provider Adapter
      ↓
Vendor API
а не вызывать SDK конкретного вендора напрямую из бизнес-логики — иначе смена провайдера превращается в хирургическую операцию на живом коде.
Когда этот путь рационален
Он хорошо работает, когда нужно быстро проверить MVP, нагрузка небольшая или нерегулярная, у команды нет MLOps-компетенций, задача хорошо решается готовой моделью и скорость запуска важнее полного контроля над inference.
Путь 2. Self-hosted открытые модели
Второй путь — развернуть open-weight модели на собственных серверах или в российском облаке. В статье мы имеем в виду прежде всего Qwen, DeepSeek, Llama, Mistral и их производные.
Главное преимущество self-hosting звучит просто:
Вы контролируете inference stack.
Но это не значит, что вы автоматически получаете более дешёвый или более качественный AI. Вы получаете контроль — а вместе с ним и ответственность, о масштабе которой многие узнают уже постфактум.
Что на самом деле нужно построить
Production inference — это точно не python model.py. Типичная архитектура выглядит куда сложнее:
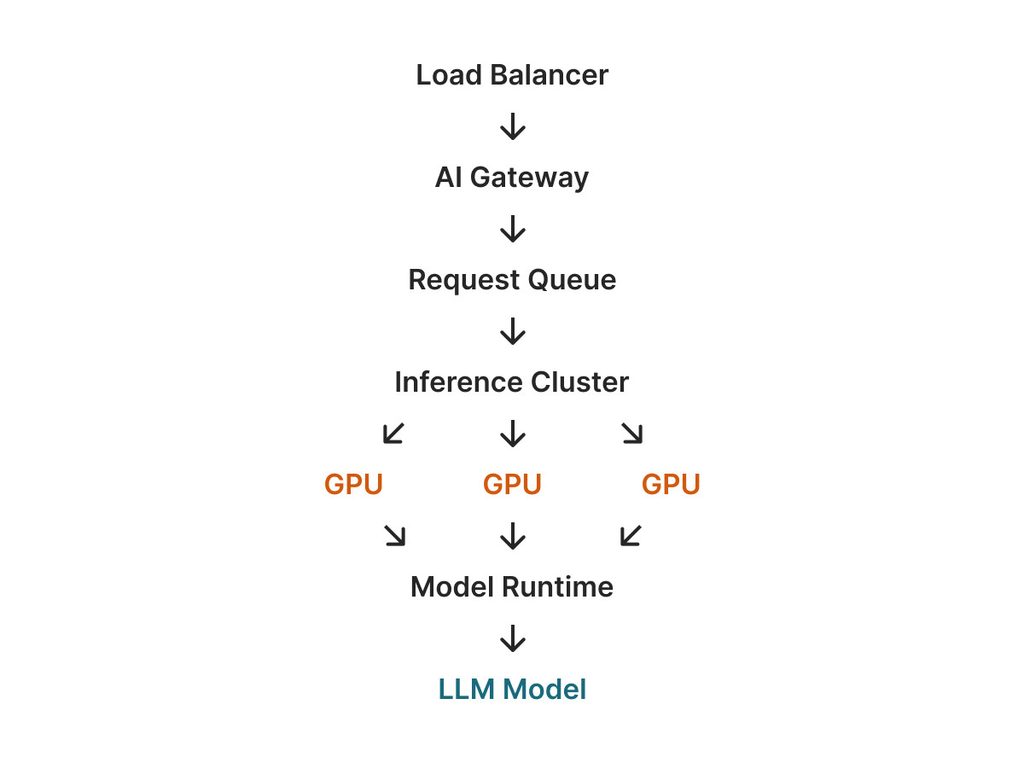
И рядом с ней — ещё один слой, о котором часто забывают на старте: метрики, логи, трейсинг, оценка качества, model registry, алертинг, автоскейлинг, secrets, access control.
Подбор инфраструктуры. Размер модели — только один из множества параметров. Учитывать нужно VRAM, quantization, context length, batch size, concurrency, соотношение input/output token, требования к latency, throughput, availability и количество replicas. Модель, которая прекрасно помещается в одну GPU при низкой нагрузке, вполне может оказаться совершенно непригодной для production, если одновременно приходит полсотни запросов.
Inference engine. Для production обычно рассматривают специализированные движки — vLLM, SGLang, TensorRT-LLM и другие runtime, поддерживающие эффективный batching и KV-cache. Ключевая задача здесь не просто получить ответ модели, а эффективно загрузить дорогостоящую GPU.
Continuous batching. Если запросы приходят независимо друг от друга, неэффективный inference обработает их последовательно, теряя львиную долю производительности GPU. Современные inference engines умеют динамически объединять такие запросы. В результате важной метрикой становится не только latency одного запроса, а целый набор: tokens/sec/GPU, requests/sec, GPU utilization, queue time, time-to-first-token, time-per-output-token.
Масштабирование. GPU нельзя рассматривать как обычный CPU-инстанс. Модель может занимать десятки гигабайт памяти, а значит запуск новой replica требует загрузки весов, инициализации runtime, прогрева и выделения VRAM — и cold start здесь может быть весьма ощутимым. Отсюда практическая необходимость в очереди, ограничении concurrency, нескольких replicas, graceful degradation, rate limiting и circuit breaker — без этого набора production попросту не выдержит нагрузку.
Мониторинг качества. Пожалуй, самая недооценённая часть self-hosting. У API-провайдера модель тоже может измениться без предупреждения, но при self-hosting вся ответственность лежит на вашей команде целиком. Мониторить только CPU, RAM, GPU, latency и errors недостаточно — нужно отдельно следить за качеством ответов: JSON validity, RAG retrieval precision, answer groundedness, hallucination rate, task accuracy, refusal rate, обратную связь пользователей.
AI Evaluation: слой, которого не хватает большинству проектов
Одна из самых дорогих ошибок, которую мы регулярно видим — выбирать LLM по принципу «я попробовал пять запросов, и эта отвечает лучше». Для production такой подход не годится в принципе — нужен собственный evaluation dataset.
Структура может выглядеть так:
evaluation/
    support_001.json
    support_002.json
    legal_003.json
    extraction_004.json
    coding_005.json
Каждый тест содержит вход, ожидаемый результат и критерии оценки:
{
  "input": "...",
  "expected": "...",
  "criteria": [...]
}
После этого модели уже можно сравнивать честно — на одном и том же наборе задач, а не по субъективным впечатлениям. Именно такой набор тестов позволяет безопасно менять модель, quantization, prompt, RAG, inference engine — и, что важнее всего, обнаруживать регрессию до того, как она попадёт в production, а не после жалоб пользователей.
RAG: отдельный источник рисков
Если AI-продукт работает с внутренними документами, RAG появится практически наверняка. Типичный pipeline выглядит так:
Documents
   ↓
Parser
   ↓
Chunking
   ↓
Embedding Model
   ↓
Vector DB
   ↓
Retriever
   ↓
Reranker
   ↓
Context
   ↓
LLM
Каждый из этих компонентов влияет на качество итогового ответа. Можно иметь отличную LLM, но посредственный retriever — и тогда модель просто никогда не увидит нужный документ, сколько бы ни была умна сама по себе. Поэтому качество RAG нельзя мерить только качеством генерации: нужно отдельно тестировать retrieval quality, context relevance, context completeness, answer faithfulness и уже потом — итоговое качество ответа.
И ещё один момент, который часто упускают: embeddings сами по себе не являются гарантированно безопасным способом хранения данных. Если embedding создан из документа с персональной информацией, vector storage нельзя автоматически считать «безопасным просто потому что там не текст в чистом виде».
Путь 3. Гибридная архитектура
Третий путь — разделить data layer и reasoning layer. Схема может выглядеть так:
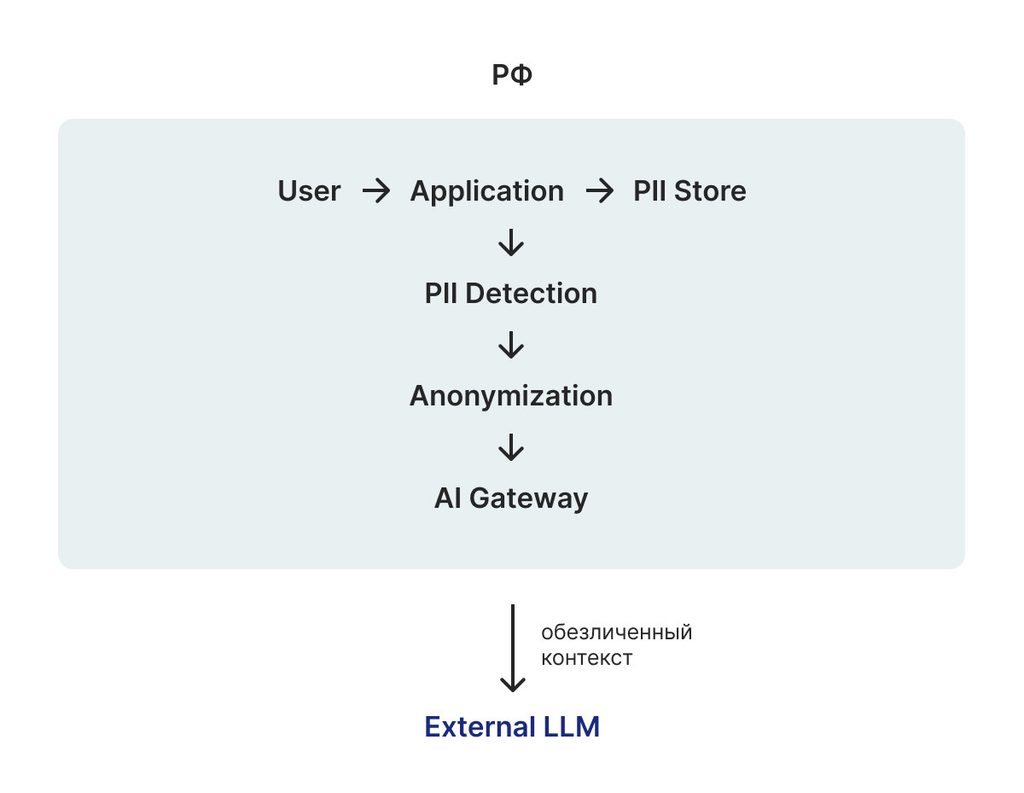
После получения ответа можно выполнить обратное сопоставление:
[USER_123] → Иван Иванов
[ORDER_456] → заказ №456
Но здесь критически важно различать два разных понятия. Псевдонимизация — это когда «Иван Иванов» превращается в USER_123, но у вас всё ещё существует таблица соответствий USER_123 → Иван Иванов, а значит идентификация потенциально восстановима. Анонимизация — это когда цель именно в том, чтобы сделать восстановление личности невозможным или существенно ограниченным с учётом применимого определения и конкретного контекста. Простая замена имени на [USER_123] сама по себе ещё ничего не доказывает — это может быть псевдонимизация, выданная за анонимизацию, и разница между ними имеет вполне реальные юридические последствия.
Как должен выглядеть production PII layer
Примитивный вариант — regex(email), regex(phone), regex(passport) — лучше, чем ничего, но откровенно недостаточен. Более зрелая схема выглядит так:
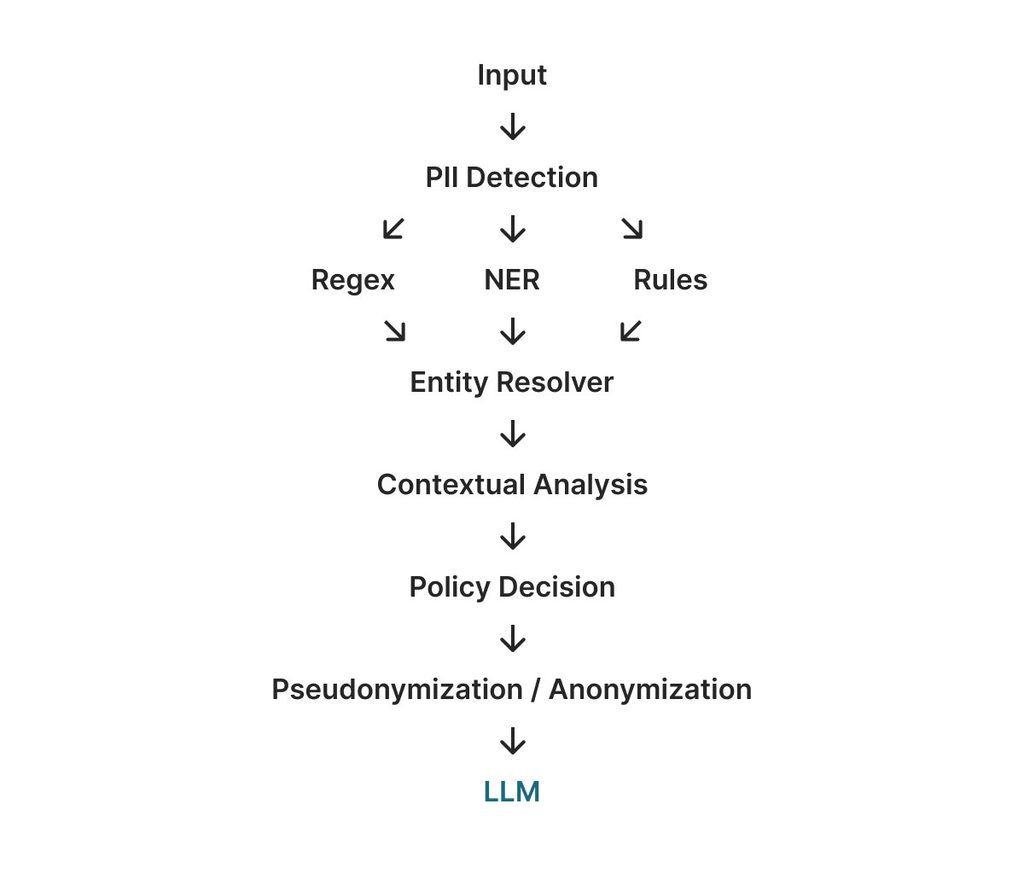
Тестировать нужно не только precision, но и recall. Пропущенный телефон вида +7 999 123-45-67 — очевидная и легко ловимая ошибка. Гораздо сложнее с фразой вроде «мой брат — единственный хирург в нашей деревне»: прямого идентификатора здесь нет, но контекст сам по себе может оказаться идентифицирующим. Именно поэтому privacy layer должен быть отдельным полноценным компонентом системы, а не набором regex-выражений внутри prompt builder.
AI Gateway — центральный архитектурный слой
Если проект рассчитан на жизнь дольше нескольких месяцев, мы бы закладывали собственный AI Gateway практически с первого дня. Пример устройства:
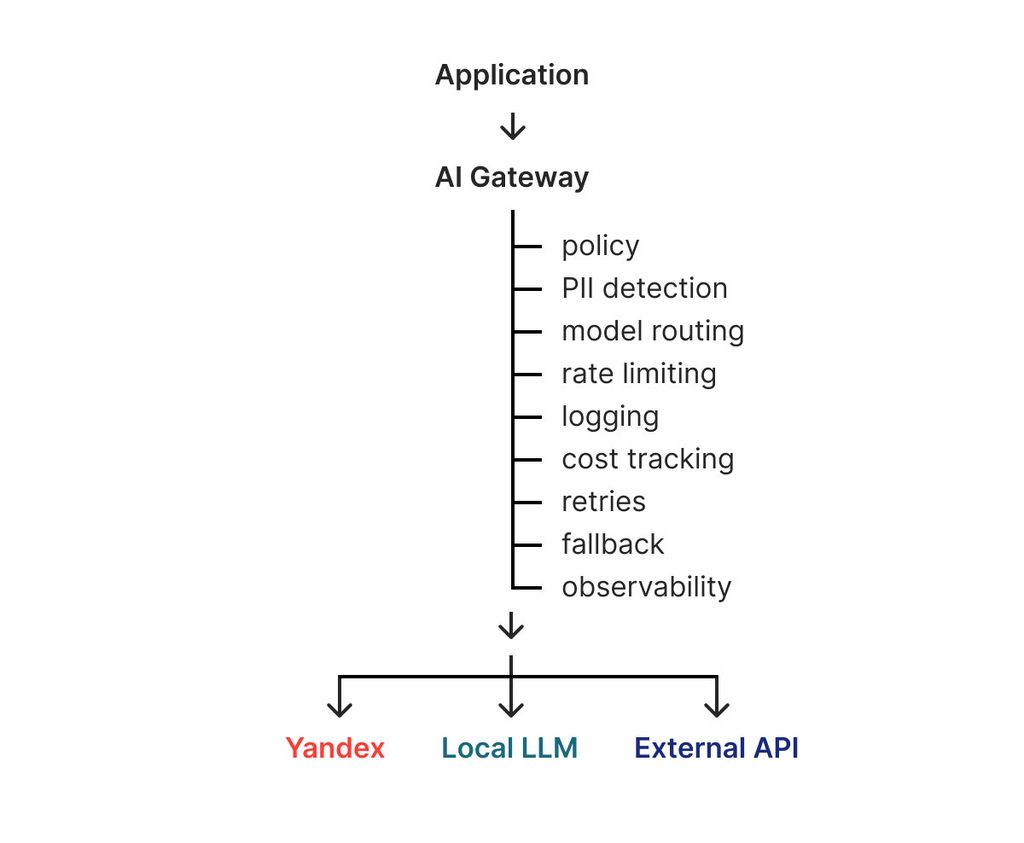
При такой схеме приложение вообще не знает, где физически работает модель:
response = ai.generate(
    task="support_answer",
    messages=messages,
    sensitivity="personal_data"
)
А дальше Gateway сам решает: персональные данные — к локальной модели; обезличенный текст с переводом — к внешней; задача, требующая глубокого reasoning, — к одной модели; задача, где важна низкая latency, — к другой. По сути, это превращает выбор модели из жёсткой архитектурной зависимости в задачу policy/routing — то есть в настройку, а не в переписывание кода.
Экономика self-hosting
Здесь нельзя ограничиваться только стоимостью GPU. Полная стоимость владения (TCO) складывается из GPU, CPU/RAM, storage, network, replicas, мониторинга, DevOps, ML-инженерии, security, backups, простаивающей мощности, апгрейдов и разбора инцидентов. Для API стоимость считается иначе — input tokens, output tokens, embeddings, reranking, tool calls и дополнительные сервисы.
Поэтому сравнивать нужно не «GPU стоит X рублей, API стоит Y рублей» — этот вопрос слишком примитивен, чтобы на нём строить решение. Правильный вопрос звучит иначе: сколько стоит обработать единицу полезной работы при требуемом SLA? Например, cost / 1M input tokens, cost / 1M output tokens, cost / successful task, cost / resolved support ticket, cost / generated document. Последняя метрика на практике часто оказывается куда полезнее любых абстрактных сравнений цены за токен.
Низкая и высокая нагрузка
При небольшой и нерегулярной нагрузке постоянная GPU-инфраструктура и правда часто невыгодна — модель простаивает, а GPU всё равно оплачивается. При высокой и стабильной нагрузке собственный inference, наоборот, может оказаться значительно выгоднее. Но точку перехода нельзя определить универсальным правилом вроде «после 150–300 тысяч рублей API надо переносить на свои GPU» — такой порог зависит от размера модели, количества input и output tokens, concurrency, SLA, стоимости GPU, количества replicas, степени их загрузки, требований к отказоустойчивости, зарплаты команды и стоимости эксплуатации. Универсального числа тут просто не существует — придётся строить собственный benchmark и TCO-модель.
Сравнение подходов
| Критерий | Российский API | Self-hosted | Гибрид |
|---|---|---|---|
| Скорость запуска | Высокая | Низкая | Средняя |
| Контроль модели | Ограниченный | Высокий | Средний/высокий |
| Контроль инфраструктуры | Ограниченный | Высокий | Высокий для локального слоя |
| Инженерная сложность | Низкая | Высокая | Высокая |
| Контроль latency | Ограниченный | Высокий | Средний |
| Качество | Зависит от провайдера | Зависит от выбранной модели | Можно выбирать модель под задачу |
| Масштабирование | Делегировано провайдеру | На вашей стороне | Комбинированное |
| Стоимость при низкой нагрузке | Обычно удобнее | Может быть высокой | Зависит от routing |
| Стоимость при высокой нагрузке | Нужно считать | Может быть привлекательной | Зависит от распределения нагрузки |
| Fine-tuning | Зависит от API | Высокий контроль | Ограничен внешней моделью |
| Privacy engineering | Проще, но требует проверки | Полный контроль периметра | Наиболее сложный |
| Vendor lock-in | Выше | Ниже | Ниже |
| Требования к ML/MLOps | Низкие | Высокие | Высокие |
Что делать на разных стадиях проекта
MVP. Главная задача MVP — проверить продуктовую гипотезу, а не построить идеальную инфраструктуру. Поэтому архитектура должна минимизировать инженерную работу:
Application
     ↓
AI Gateway
     ↓
Commercial API
Но AI Gateway всё равно стоит сделать уже сейчас — тогда через несколько месяцев замена Commercial API на self-hosted LLM не потребует переписывать бизнес-логику, а станет локальной технической заменой одного компонента.
Product-market fit. Когда появляется стабильная пользовательская нагрузка, начинаем собирать реальные данные: requests/day, tokens/request, latency, cost/request, quality, failure rate, обратную связь пользователей — и на этой базе создаём evaluation dataset. На этом этапе уже можно честно сравнить несколько моделей на собственном workload, а не на абстрактных бенчмарках.
Scale. Когда AI становится существенной частью себестоимости продукта, имеет смысл моделировать API TCO против Self-hosted TCO против Hybrid TCO и проводить полноценный нагрузочный benchmark. При этом миграция на self-hosting должна быть оправдана не самим фактом роста расходов, а совокупностью стоимости, SLA, latency, качества, контроля и требований к данным — иначе есть риск променять управляемость на иллюзорную экономию.
Регулируемые отрасли
Для финансовых, медицинских и государственных продуктов 152-ФЗ нельзя рассматривать изолированно. Могут существовать дополнительные требования к медицинской информации, банковской тайне, коммерческой тайне, критической инфраструктуре, информационной безопасности, доступу сотрудников, журналированию и хранению данных. Поэтому архитектура должна проектироваться от классификации данных, а не от выбора конкретной LLM. Пример такой классификации:
PUBLIC
  → any approved model

INTERNAL
  → approved cloud models

PERSONAL
  → controlled processing

SENSITIVE
  → restricted/local processing

HIGHLY REGULATED
  → dedicated compliant environment
Такой подход значительно устойчивее, чем универсальное правило «всё отправляем в российскую модель», которое ломается ровно в тот момент, когда у продукта появляется хотя бы одна нетиповая категория данных.
Частые ошибки команд
Многим регулярно попадаются одни и те же грабли, поэтому стоит перечислить их отдельно.
➡️ Считать российский дата-центр гарантией compliance — самая распространённая ошибка. Адрес дата-центра — лишь один элемент картины; проверять нужно весь data-flow: storage, backup, логи, мониторинг, поддержку, аналитику, интеграции с третьими сторонами. Важно понимать, где физически оказываются данные и кто реально имеет к ним доступ, а не только где стоит основной сервер.
➡️ Считать [USER_123] полноценной анонимизацией — это может быть всего лишь псевдонимизация, а не полная анонимизация, и разница здесь не формальная, а юридическая. Кроме прямых идентификаторов всегда нужно учитывать контекст.
➡️ Забывать про RAG — можно тщательно защитить основной prompt и одновременно случайно передать ПДн через vector DB, retriever, document chunk, chat history или metadata, даже не заметив этого.
➡️ Использовать только regex — он хорошо ловит очевидные шаблоны, но не решает задачу контекстной идентификации в принципе.
➡️ Считать только GPU — self-hosting это не покупка железа, а эксплуатация полноценной распределённой AI-системы со всеми вытекающими операционными обязательствами.
➡️ Не иметь evaluation dataset — без фиксированного набора тестов невозможно надёжно утверждать «новая модель лучше старой». Легко получить более дешёвую или быструю модель, которая незаметно ухудшила ключевую бизнес-метрику.
➡️ Привязывать бизнес-логику к конкретному SDK — плохо, когда в десятках мест приложения разбросано from vendor_sdk import Model. Лучше иметь единый вызов ai.generate(...) и один слой адаптеров под капотом.
➡️ И, наконец, забывать про лицензии. «Open source», «open weights» и «можно свободно использовать в коммерческом продукте» — вовсе не синонимы. Перед использованием любой модели нужно проверять именно её актуальные лицензионные условия, а не полагаться на репутацию проекта.
Архитектура, которую мы бы закладывали с самого начала
Для нового AI-продукта мы обычно исходим примерно из такой схемы:
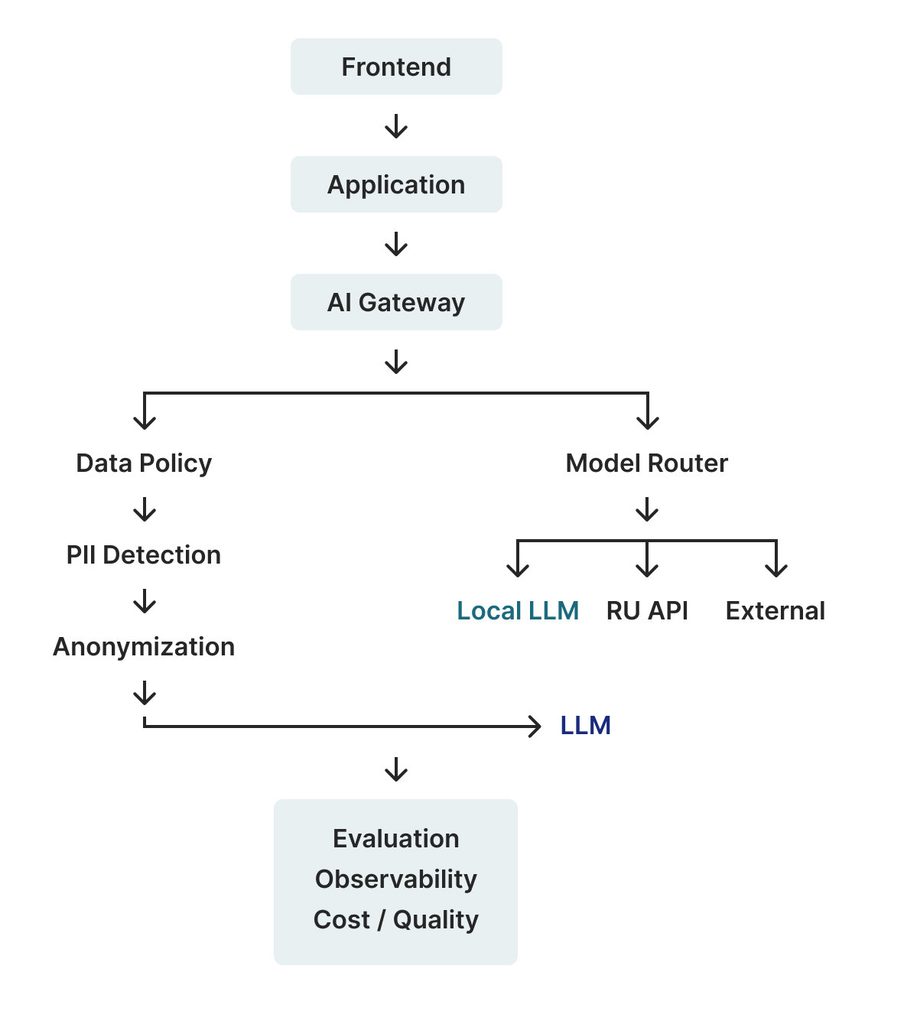
А данные при этом живут отдельным контуром:
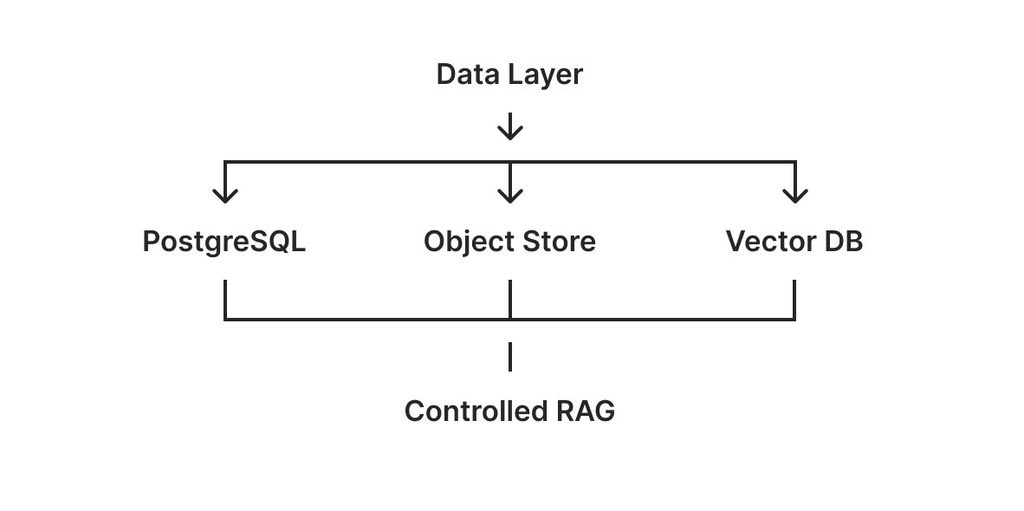
В такой архитектуре смена модели становится относительно локальной операцией: можно начать с RU API, затем добавить Qwen, потом DeepSeek, и при необходимости подключить ещё один API — не трогая при этом основную бизнес-логику продукта.
Вывод
Разработка AI-продуктов под требования 152-ФЗ — это не столько вопрос выбора «российской или зарубежной LLM», сколько вопрос архитектуры данных и контроля над AI-пайплайном в целом.
Наивная модель выглядит так: User → Backend → LLM. Production-система гораздо ближе к куда более длинной цепочке: пользователь, приложение, классификация данных, слой PII / чувствительных данных, RAG/retrieval, AI Gateway, роутер моделей — с ветвлением на российский API, self-hosted LLM и внешний API, — и наконец слой evaluation и observability поверх всего этого.
Коммерческие российские LLM дают быстрый путь к MVP и снимают значительную часть инфраструктурной нагрузки. Self-hosted модели дают больше контроля над runtime, данными, моделью и экономикой при достаточной нагрузке, но требуют полноценной ML/MLOps-компетенции в команде. Гибридная архитектура позволяет разделить хранение и обработку чувствительных данных от model reasoning, но платит за это заметно более серьёзным privacy engineering и юридической проверкой.
Поэтому не стоит выбирать один путь навсегда. Куда полезнее с самого начала сделать четыре вещи: отделить данные от model runtime; ввести AI Gateway между приложением и моделями; сделать data/PII policy отдельным архитектурным слоем; создать evaluation dataset для объективного сравнения моделей. Тогда смена модели, провайдера, нагрузки или требований к комплаенсу не превращается в переписывание продукта с нуля.
Именно это, на наш взгляд, и есть самый практичный подход к AI-архитектуре: не пытаться угадать, какая модель окажется лучшей через год, а построить систему, в которой модель можно заменить без разрушения всего остального.


